01
le défi
Le laboratoire d'orthodontie pilotait sa production sur Monday.com. Comme tableau, l'outil faisait le travail, mais il traînait trois problèmes qu'aucun réglage ne corrige : il se paie par utilisateur et par mois, indéfiniment ; les données — liées à des patients — vivent sur un serveur tiers ; et rien du métier n'y existe. Lots, péremptions, scan des codes médicaux, consommation de matière par travail : soit on les bricole par-dessus avec des automatisations fragiles, soit ils ne sont pas là.
En parallèle courait une obligation légale. Un laboratoire qui fabrique des dispositifs médicaux sur mesure doit, sous le règlement européen MDR, pouvoir relier chaque appareil livré au lot de matériau qui a servi à le faire : si un lot de résine sort défectueux, il faut savoir chez quels patients il a été posé. Cela se tenait dans un tableur et dans la mémoire de ceux qui fabriquent.
La commande avait donc deux moitiés : remplacer l'abonnement par un outil à soi, et faire que cet outil règle ce que l'abonnement ne réglait pas.
02
la solution
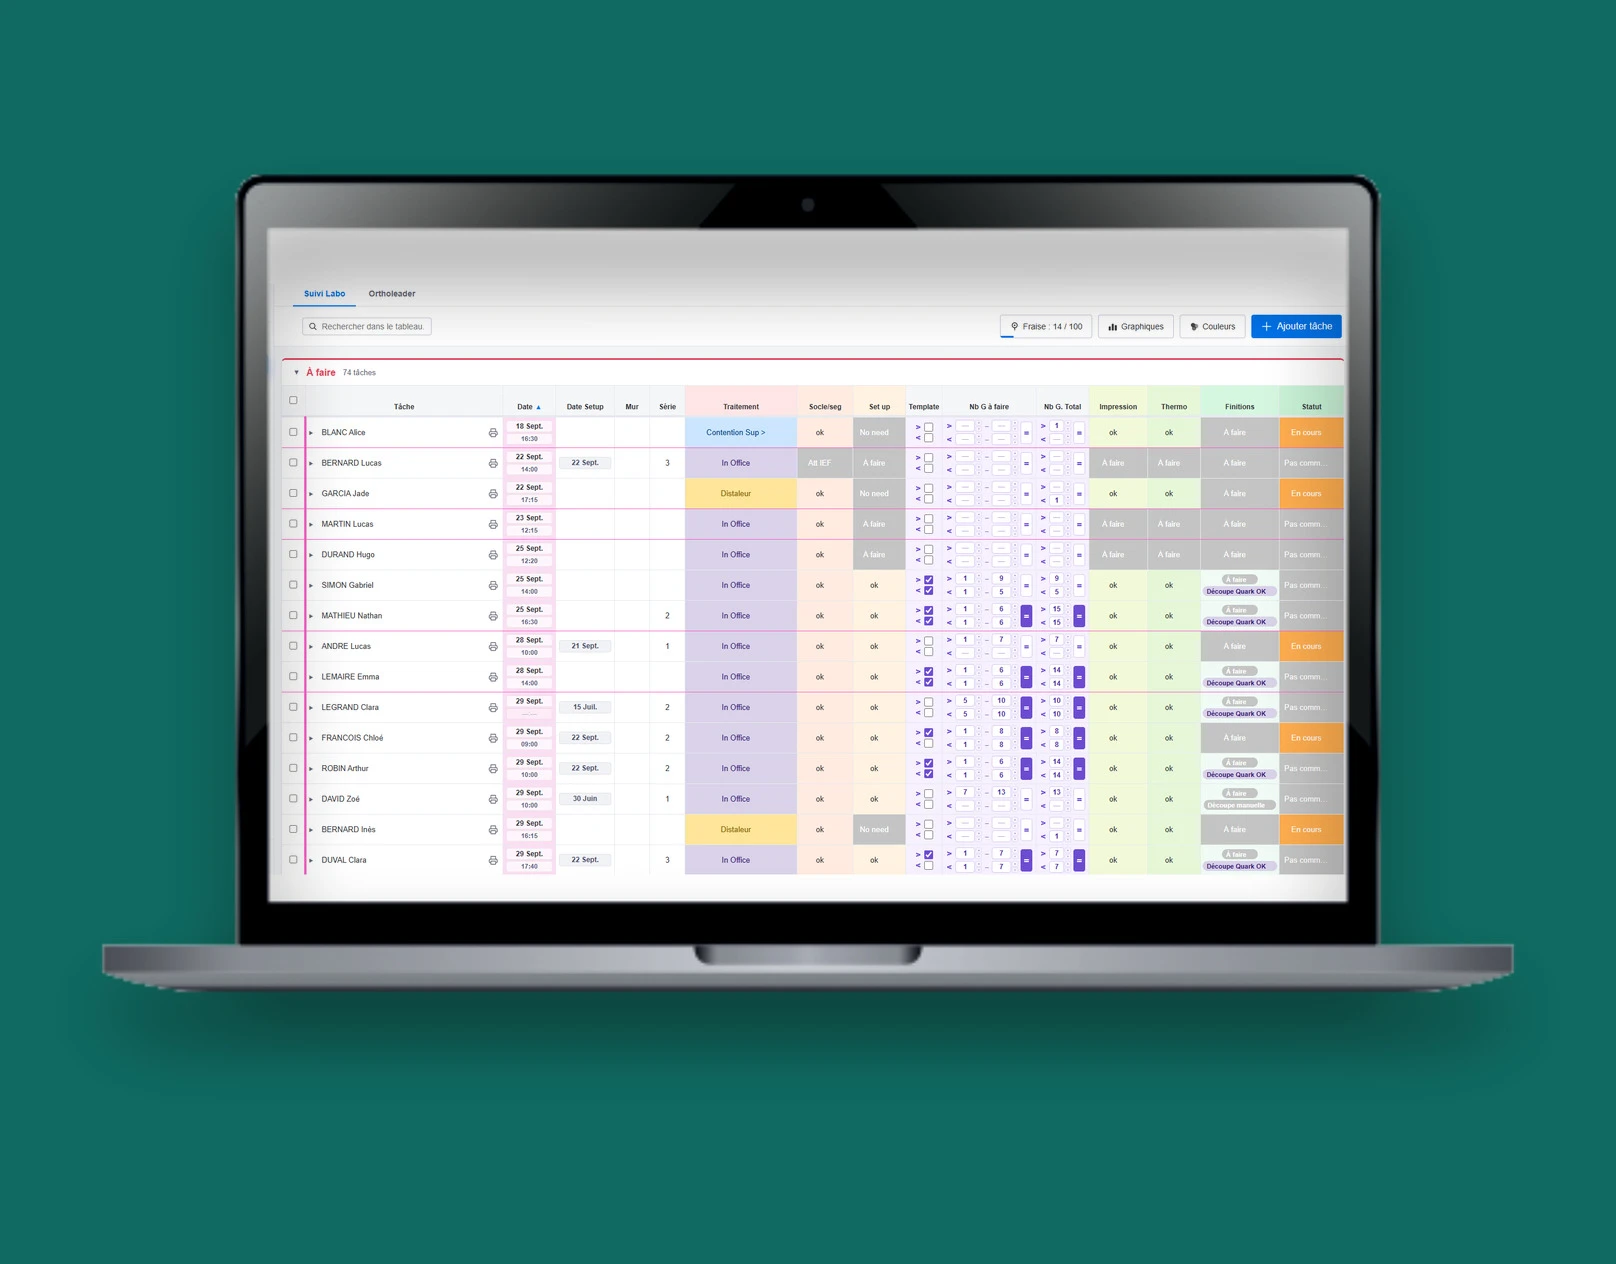
Une application de bureau conçue, développée et déployée de zéro, installée sur les postes du cabinet.
Le parti pris d'interface : copier délibérément l'ergonomie de Monday — tableaux, colonnes de statut à étiquettes de couleur, édition en ligne — pour que personne n'ait à réapprendre à travailler. Changer d'outil ne devait pas se sentir comme changer d'outil. Dessous, en revanche, tout ce qui manquait : lots et péremptions, scan GS1 DataMatrix qui apporte code, lot et date de péremption en un seul tir de lecteur, décompte automatique du stock, étapes de fabrication horodatées, et la chaîne lot → consommation → cas fermée sans travail manuel supplémentaire.
La décision structurelle : le cœur de l'application ne parle jamais à une base de données, il parle à une interface unique, avec deux implémentations interchangeables — SQLite en local, PostgreSQL en partagé. L'application a donc pu démarrer sur un seul poste et passer des mois plus tard à une base commune sans être réécrite.
Le passage à l'échelle est écrit, pas improvisé : PostgreSQL en Docker sur le NAS du cabinet et volontairement pas sur le serveur de domaine, postes pointant sur un nom DNS et jamais sur une IP, installation par utilisateur sans droits administrateur, reprise de l'historique en une seule transaction vérifiée avec retour arrière, et un manuel de mise en service en français — hébergement et solutions de repli, réseau et pare-feu, sauvegardes et test de restauration, symptômes fréquents.
03
le résultat
En production, six postes, base partagée et mise à jour en temps réel entre eux.
L'abonnement est supprimé et le cabinet est propriétaire de l'outil qu'il utilise ; les données patients sont restées chez lui ; l'exigence réglementaire est close — d'un lot défectueux on remonte aux patients, et d'un patient à ses lots. À ce jour : 293 cas tracés, 1 738 étapes de production horodatées, 8 tables et 20 807 lignes de TypeScript.
Ce que j'en retiens tient dans trois pannes. Un stock descendu à −6 parce que deux postes lisaient avant d'écrire, corrigé par verrou de ligne et vérifié avec deux instances contre un vrai PostgreSQL. Une coupure réseau qui fermait l'application entière au lieu de la dégrader, devenue une reconnexion à attente croissante qui se resynchronise. Et des prévisions de rupture fantaisistes — dix-neuf ans d'autonomie sur une plaque — nées d'une même formule copiée trois fois et divergée. Depuis, quand la base de calcul est trop mince, les panneaux refusent de répondre et disent pourquoi : un chiffre inventé sur lequel quelqu'un va commander de la matière est pire qu'un tiret.